Mis à jour le 13 septembre 2026
Une IA locale, sur votre propre machine
Faites tourner un assistant IA (LLM) directement sur votre ordinateur — sans envoyer vos données vers un cloud, sans abonnement mensuel. Montage à l'atelier de La Chapelle-sur-Erdre (Nantes Nord).
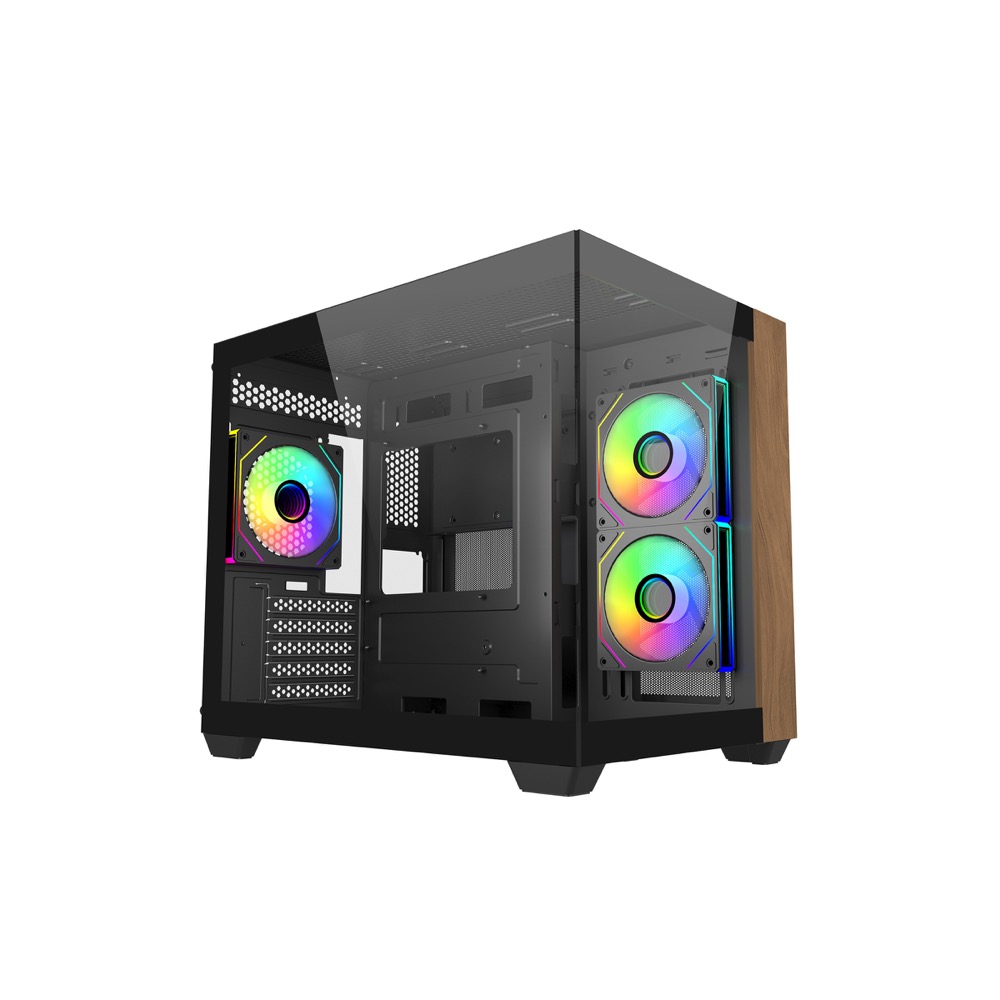
Boîtier de la configuration Entrée de gamme — composants exacts détaillés ci-dessous
2 machines, 2 niveaux de modèles
Le prix affiché correspond à la machine seule, montée et testée à l'atelier. Livraison, installation du logiciel IA et configuration d'un agent sur mesure sont proposées en option — voir plus bas.
- Processeur
- Ryzen 5 5600X
- Carte graphique
- RTX 5050 · 8 Go
- Mémoire
- 16 Go DDR4
- Stockage
- 512 Go NVMe
- Processeur
- Ryzen 7 7700X
- Carte graphique
- RTX 5060 Ti · 16 Go
- Mémoire
- 32 Go DDR5
- Stockage
- 1 To NVMe
Un modèle installé chez vous, pas loué en ligne
Le seul coût, c'est la machine. Pas de facture qui grimpe avec le nombre de requêtes, pas d'abonnement mensuel à une API.
Rien ne transite vers un serveur tiers : confidentialité totale, utile pour les professions à secret professionnel.
Votre IA reste disponible même en cas de coupure internet ou de réseau instable.
Aucun quota, aucun plafond mensuel imposé par un fournisseur.
Quelle taille de modèle, pour quelle machine ?
La mémoire vidéo (VRAM) de la carte graphique doit être au moins égale à ce que le modèle demande. Ce qui compte, c'est la taille du modèle — pas l'éditeur : un modèle d'environ 14 milliards de paramètres, Qwen, Llama, Mistral ou DeepSeek, demande sensiblement la même VRAM.
| Configuration | ~8B | ~14B | ~32B | ~72B |
|---|---|---|---|---|
| Entrée de gammeRTX 5050 · 8 Go | Recommandé | Non disponible | Non disponible | Non disponible |
| Référence IARTX 5060 Ti · 16 Go | Recommandé | Recommandé | Non disponible | Non disponible |
Modèles ~32B (22 Go de VRAM) et ~72B (48 Go) non couverts par nos configurations actuelles — nous contacter pour un devis sur mesure.
Quels modèles sont compatibles ?
Qwen n'est qu'un exemple : tous les modèles ouverts de taille comparable fonctionnent sur les mêmes machines.
~8B
6 Go de VRAM et plus- Qwen3 8B
- Llama 3.1 8B
- Mistral 7B
~14B
12 Go de VRAM et plus- Qwen3 / Qwen3.5 14B
- DeepSeek-R1-Distill-Qwen-14B
- Gemma 3/4 12B (proche)
~32B
22 Go de VRAM et plus- Qwen3 32B / Qwen Coder 32B
- DeepSeek-R1-Distill-Qwen-32B
- Gemma 4 27B (proche)
~72B
48 Go de VRAM et plus- Qwen 72B
- Llama 70B
- DeepSeek-R1-Distill-Llama-70B
De nouveaux modèles sortent chaque mois : cette liste donne un ordre de grandeur, pas un catalogue figé.
Vous avez déjà un modèle en tête ?
Choisissez la taille du modèle que vous voulez faire tourner, nous vous indiquons la configuration adaptée.
Le pack installation et agent IA
Au-delà de la machine, nous proposons un service complet pour que votre IA soit opérationnelle dès la livraison — en option, sur devis selon votre usage.
Choix du modèle adapté
Selon votre métier et votre usage (rédaction, résumé de documents, support client...), on détermine la taille de modèle et la configuration adaptées.
Livraison de la machine
La configuration est montée et testée à l'atelier de La Chapelle-sur-Erdre, puis livrée ou remise en main propre.
Installation du logiciel IA
Installation d'Ollama ou LM Studio et du modèle choisi, réglages de base pour un fonctionnement stable en local.
Mise en place de l'agent IA
Configuration d'un assistant sur mesure pour votre activité, puis prise en main avec vous.
Bon à savoir : le prix des configurations ci-dessus correspond à la machine seule. La livraison, l'installation et la configuration de l'agent IA sont un service à part, sur devis — contactez-nous pour en discuter.
C'est quoi, un token par seconde ?
Un token est un petit morceau de mot — en moyenne, un mot représente environ 1,3 token. Le chiffre « tokens par seconde » indique la vitesse à laquelle la réponse s'affiche à l'écran.
Repère : une personne lit en moyenne 3 à 4 mots par seconde. À partir de 15-20 tokens/s, le texte apparaît déjà plus vite que vous ne pouvez le lire — au-delà, le confort ne change plus vraiment.
RAM ou VRAM, quelle différence ?
Ce sont deux mémoires différentes. La RAM fait tourner l'ordinateur en général. La VRAM (mémoire de la carte graphique) détermine la taille du modèle IA que la machine peut faire tourner.
Beaucoup de RAM mais peu de VRAM : la configuration reste limitée aux modèles légers — c'est la VRAM qui fixe la limite.
FAQ
Qu'est-ce qu'un agent IA ?
Un assistant configuré à partir du modèle de langage installé, adapté à un usage précis de votre métier (répondre à des emails types, résumer des documents, rédiger des devis...) plutôt qu'un simple chatbot généraliste.
Quel logiciel utilisez-vous pour faire tourner l'IA en local ?
Des outils reconnus comme Ollama ou LM Studio, qui font tourner les modèles ouverts (Qwen, Llama, Mistral, DeepSeek...) directement sur votre machine.
L'installation et l'agent IA sont-ils inclus dans le prix affiché ?
Non, le prix affiché correspond à la machine seule. La livraison, l'installation du logiciel et la configuration d'un agent IA sur mesure sont proposées en option, sur devis selon votre usage.
Puis-je changer de modèle plus tard ?
Oui. Les modèles installés en local peuvent être remplacés ou mis à jour, dans la limite de la VRAM disponible sur votre configuration.
Faut-il une connexion internet pour utiliser l'IA ?
Non, une fois le modèle installé, il fonctionne hors connexion. Une connexion internet n'est utile que pour télécharger ou mettre à jour un modèle.